
Übersicht
Stoppwörter sind Wörter, die der Analyzer beim Indexieren von Dokumenten und bei der Suche entfernt. Im Stoppwort-Wörterbuch können Sie die zu entfernenden Wörter verwalten.
Bemerkung
Stoppwort-Wörterbücher sind Dateien pro Sprache (en/stopwords.txt, ja/stopwords.txt usw.), und jede wird nur vom Analyzer der jeweiligen Sprache verwendet. en/stopwords.txt wird für die Analyse der Felder content und title sowie der _en-Felder wie content_en verwendet, während content_ja und title_ja von Dokumenten, die als Japanisch erkannt wurden, mit ja/stopwords.txt analysiert werden. Sprachspezifische Felder wie content_ja werden je nach Sprache der Anfrage zur Abfrage hinzugefügt. Ein Wort, das nur zu en/stopwords.txt hinzugefügt wurde, kann daher über ein sprachspezifisches Feld weiterhin gefunden werden. Damit ein Wort nicht mehr gefunden wird, fügen Sie es auch dem Stoppwort-Wörterbuch der Sprache der Dokumente hinzu.
Stoppwörter werden mit jedem Token verglichen, das der Analyzer erzeugt. Ein Wort, das der Analyzer in mehrere Token zerlegt, etwa ein Wort aus Buchstaben und Ziffern, wird nicht entfernt, wenn es unverändert hinzugefügt wird. Wie ein Wort zerlegt wird, können Sie mit der _analyze-API von OpenSearch prüfen.
Verwaltung
Anzeige
Um die Stoppwort-Konfigurationsübersichtsseite zu öffnen, wählen Sie im linken Menü [System > Wörterbuch] aus und klicken Sie dann auf stopwords.
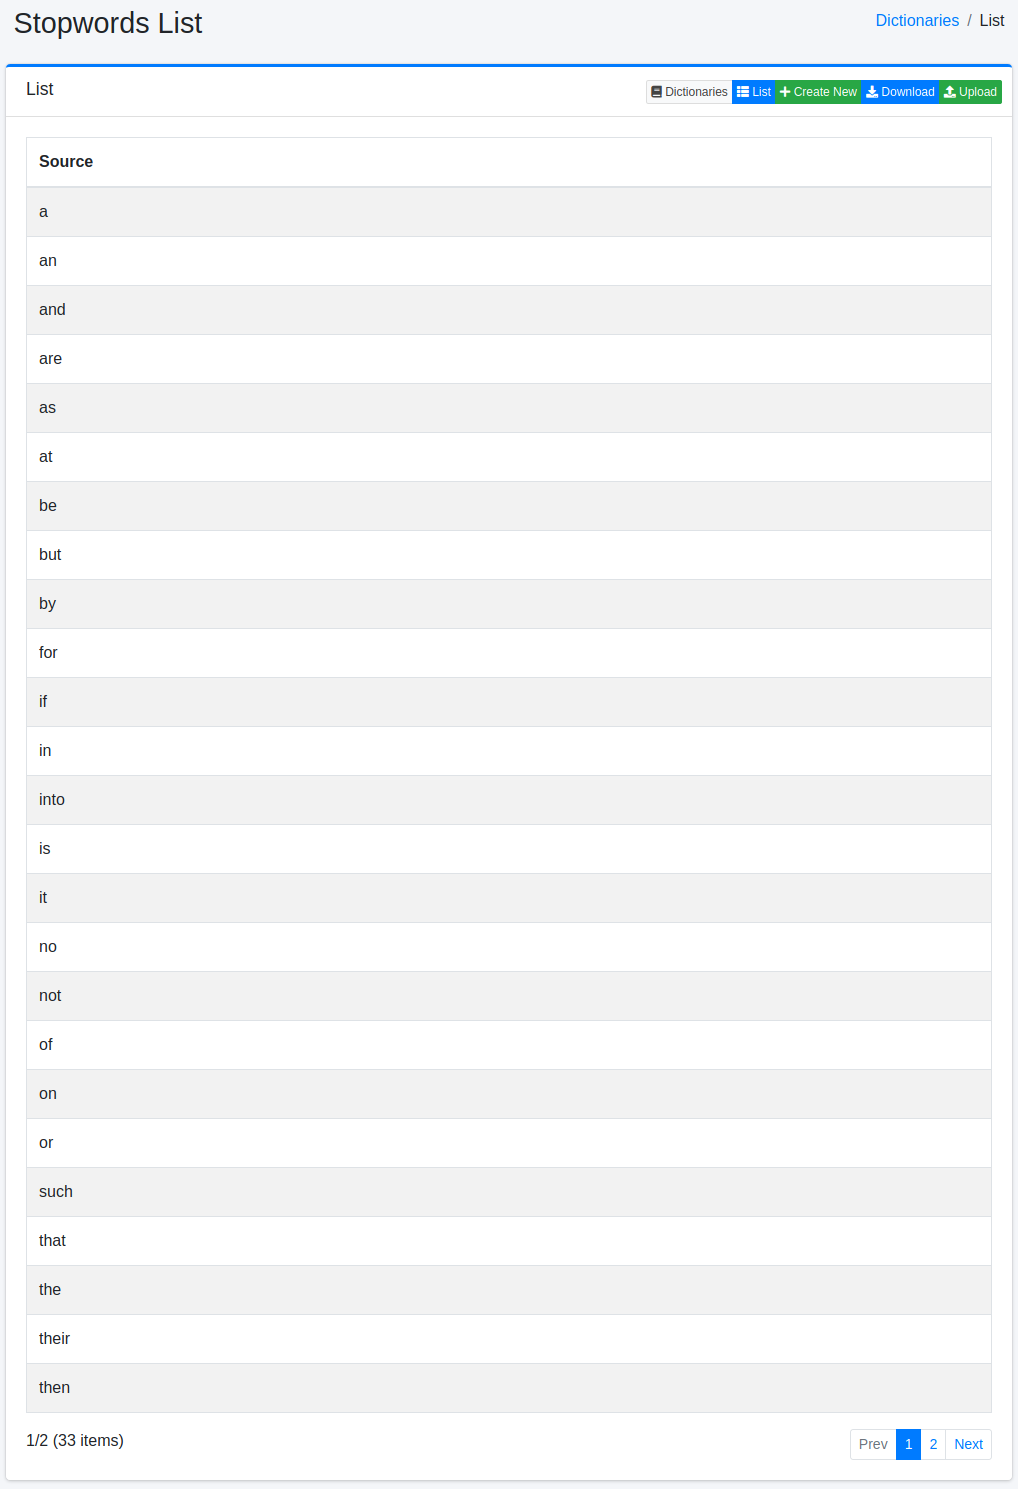
Klicken Sie auf den Konfigurationsnamen, um ihn zu bearbeiten.
Konfigurationsmethode
Um die Stoppwort-Konfigurationsseite zu öffnen, klicken Sie auf die Schaltfläche „Neu erstellen“.
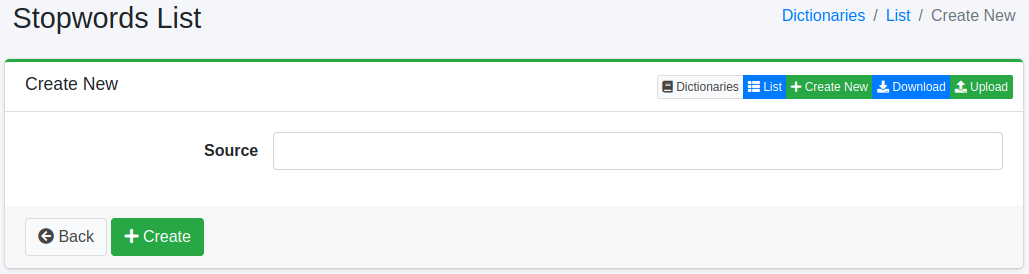
Konfigurationsparameter
Wortinformationen
Geben Sie das Wort ein, das als Stoppwort entfernt werden soll.
Download
Sie können das Stoppwort-Wörterbuch als Textdatei mit einem Wort pro Zeile herunterladen.
Upload
Sie können eine Textdatei mit einem Wort pro Zeile hochladen. Zeilen, die mit # beginnen, werden als Kommentare behandelt.