
Descripción general
Las palabras vacías son palabras que el analizador elimina al indexar los documentos y al realizar búsquedas. El diccionario de palabras vacías le permite administrar las palabras que se eliminan.
Nota
Los diccionarios de palabras vacías son archivos por idioma (en/stopwords.txt, ja/stopwords.txt, etc.), y cada uno solo lo usa el analizador de su idioma. en/stopwords.txt se usa para analizar los campos content y title y los campos _en como content_en, mientras que content_ja y title_ja de los documentos detectados como japonés se analizan con ja/stopwords.txt. Los campos específicos de idioma como content_ja se añaden a la consulta según el idioma de la solicitud, por lo que una palabra añadida solo a en/stopwords.txt puede seguir coincidiendo a través de un campo específico de idioma. Para que una palabra deje de coincidir, añádala también al diccionario de palabras vacías del idioma de los documentos.
Las palabras vacías se comparan con cada token que genera el analizador. Una palabra que el analizador divide en varios tokens, como una palabra que mezcla letras y dígitos, no se elimina si se añade tal cual. Puede comprobar cómo se divide una palabra con la API _analyze de OpenSearch.
Método de gestión
Método de visualización
Para abrir la página de lista de configuración de palabras vacías que se muestra a continuación, seleccione [Sistema > Diccionario] en el menú izquierdo y luego haga clic en stopwords.
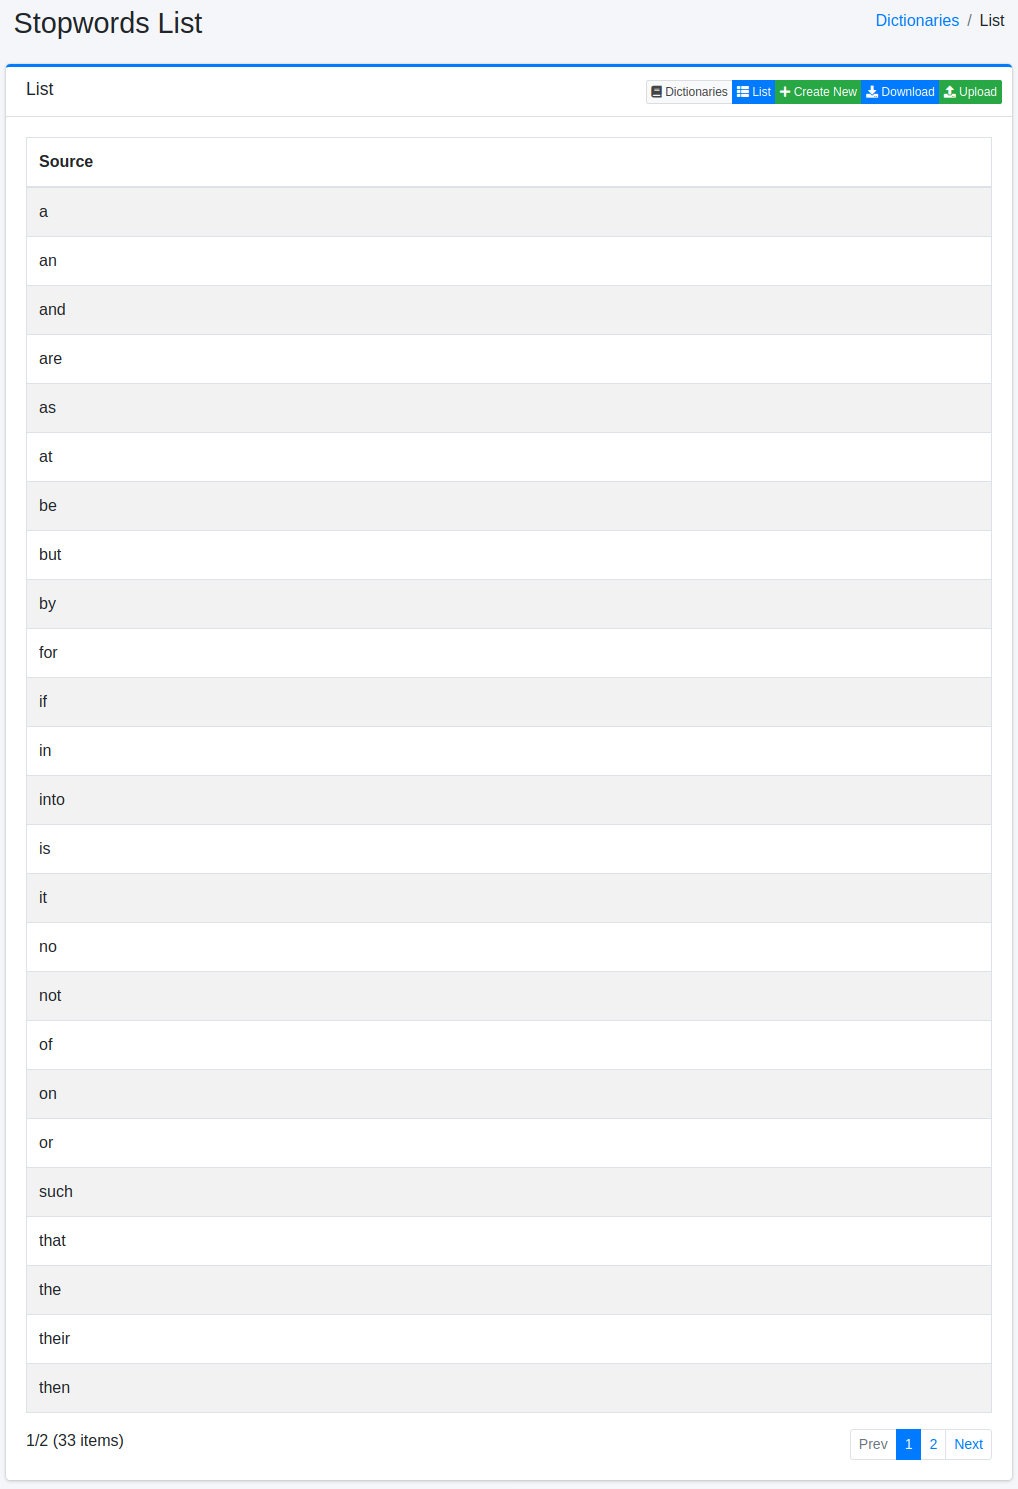
Para editar, haga clic en el nombre de la configuración.
Método de configuración
Para abrir la página de configuración de palabras vacías, haga clic en el botón de nueva creación.
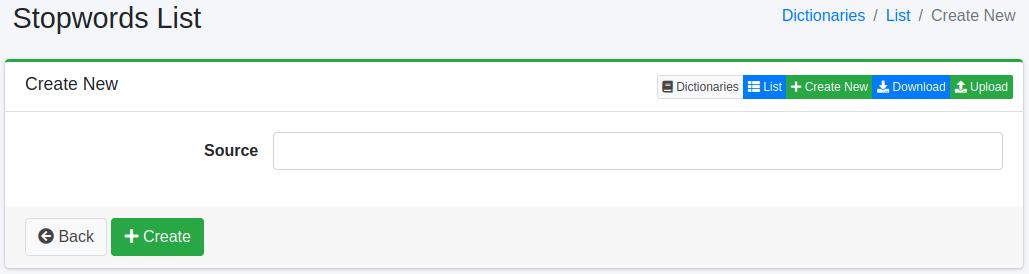
Parámetros de configuración
Información de la palabra
Ingrese la palabra que se eliminará como palabra vacía.
Descarga
Puede descargar el diccionario de palabras vacías como un archivo de texto con una palabra por línea.
Carga
Puede cargar un archivo de texto con una palabra por línea. Las líneas que comienzan con # se tratan como comentarios.