
개요
불용어는 문서를 인덱싱할 때와 검색할 때 애널라이저가 제거하는 단어입니다. 불용어 사전에서는 제거할 단어를 관리할 수 있습니다.
참고
불용어 사전은 언어별 파일( en/stopwords.txt , ja/stopwords.txt 등)이며, 각각 해당 언어의 애널라이저에서만 사용됩니다. en/stopwords.txt 는 content · title 필드와 content_en 등의 _en 필드 분석에 사용되고, 일본어로 판정된 문서의 content_ja · title_ja 분석에는 ja/stopwords.txt 가 사용됩니다. content_ja 등의 언어별 필드는 요청 언어에 따라 검색 조건에 추가되므로, en/stopwords.txt 에만 추가한 단어는 언어별 필드를 통해 계속 검색될 수 있습니다. 검색되지 않게 하려는 단어는 대상 문서 언어의 불용어 사전에도 추가하십시오.
불용어는 애널라이저가 분할한 단어(토큰)마다 비교됩니다. 영문자와 숫자가 섞인 단어처럼 애널라이저가 여러 토큰으로 분할하는 단어는 그대로 추가해도 제거되지 않습니다. 단어가 어떻게 분할되는지는 OpenSearch의 _analyze API로 확인할 수 있습니다.
관리 방법
표시 방법
아래 그림의 불용어 설정 목록 페이지를 열려면 왼쪽 메뉴의 [시스템 > 사전]을 선택한 후 stopwords를 클릭합니다.
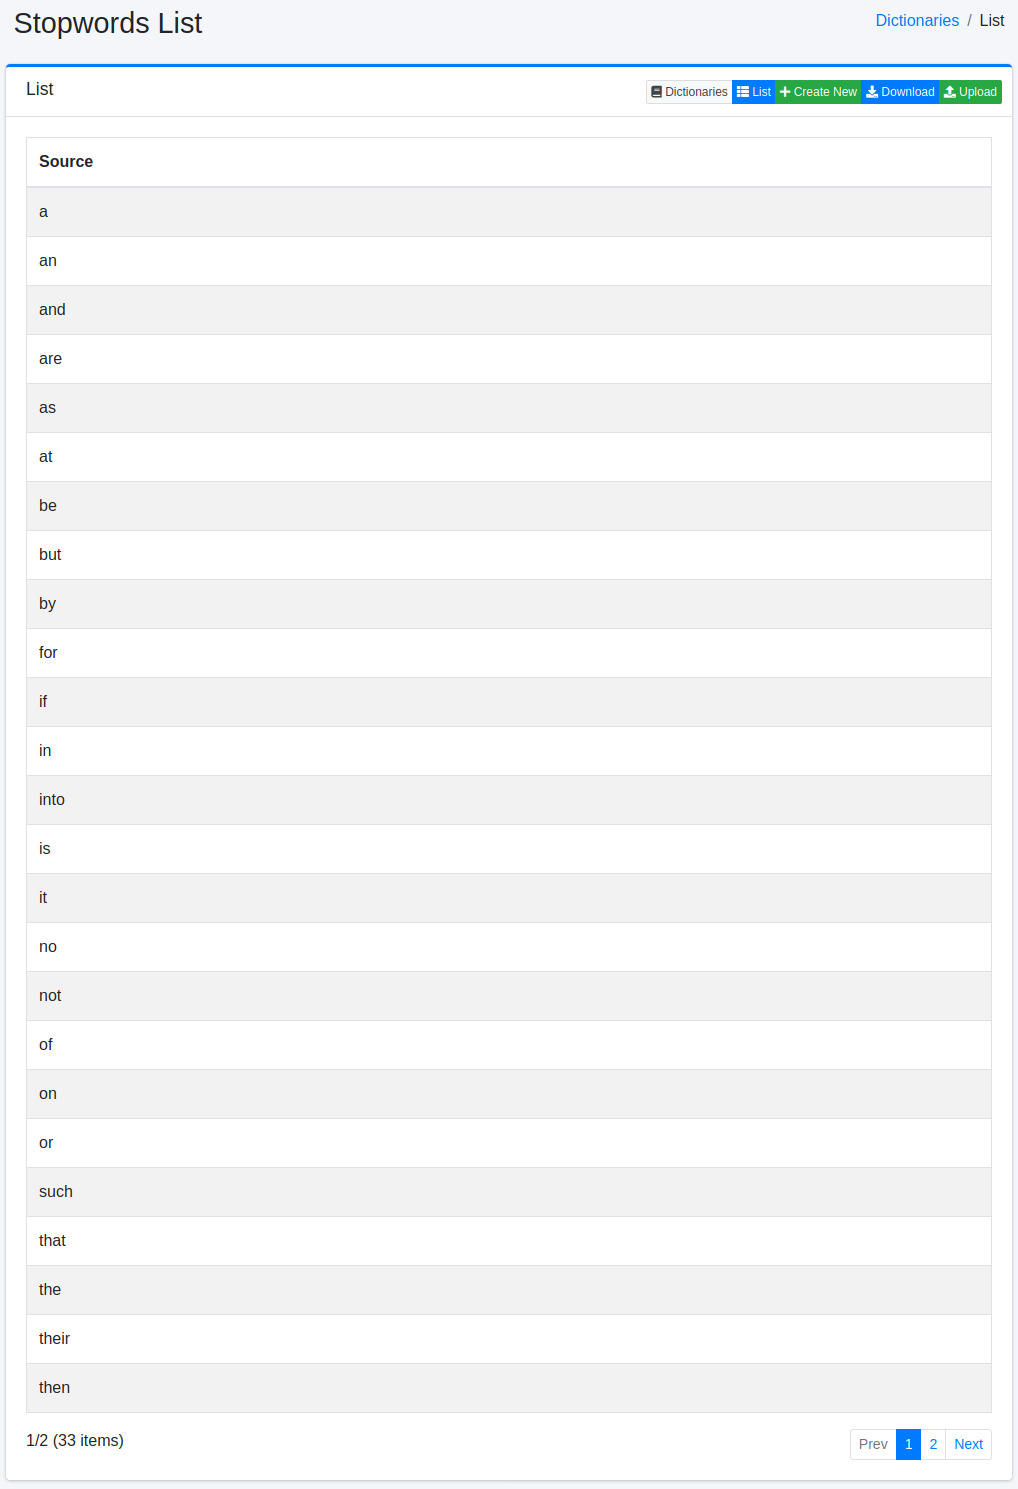
편집하려면 설정 이름을 클릭합니다.
설정 방법
불용어 설정 페이지를 열려면 신규 생성 버튼을 클릭합니다.
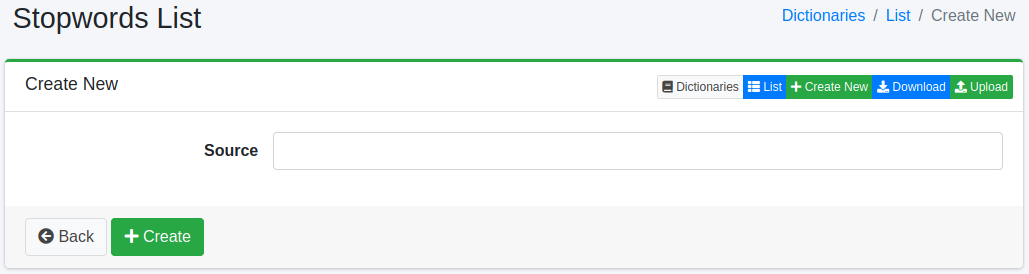
설정 항목
단어 정보
불용어로 제거할 단어를 입력합니다.
다운로드
불용어 사전을 한 줄에 한 단어씩 기술한 텍스트 형식으로 다운로드할 수 있습니다.
업로드
한 줄에 한 단어씩 기술한 텍스트 형식의 파일을 업로드할 수 있습니다. # 으로 시작하는 줄은 주석으로 취급됩니다.