
Présentation
Cette section explique les paramètres de configuration concernant les dictionnaires.
Les modifications du dictionnaire doivent être effectuées avec une compréhension des spécifications de chaque dictionnaire. Un échec lors de la modification du dictionnaire peut rendre l’index inaccessible.
Note
Si search_engine.type vaut vanilla ou aws (c’est-à-dire si OpenSearch n’a pas les plugins CodeLibs), la gestion des dictionnaires n’est pas disponible. Voir Type de moteur de recherche.
Liste
Pour ouvrir la page de liste des dictionnaires gérables illustrée ci-dessous, cliquez sur [Système > Dictionnaire] dans le menu de gauche.
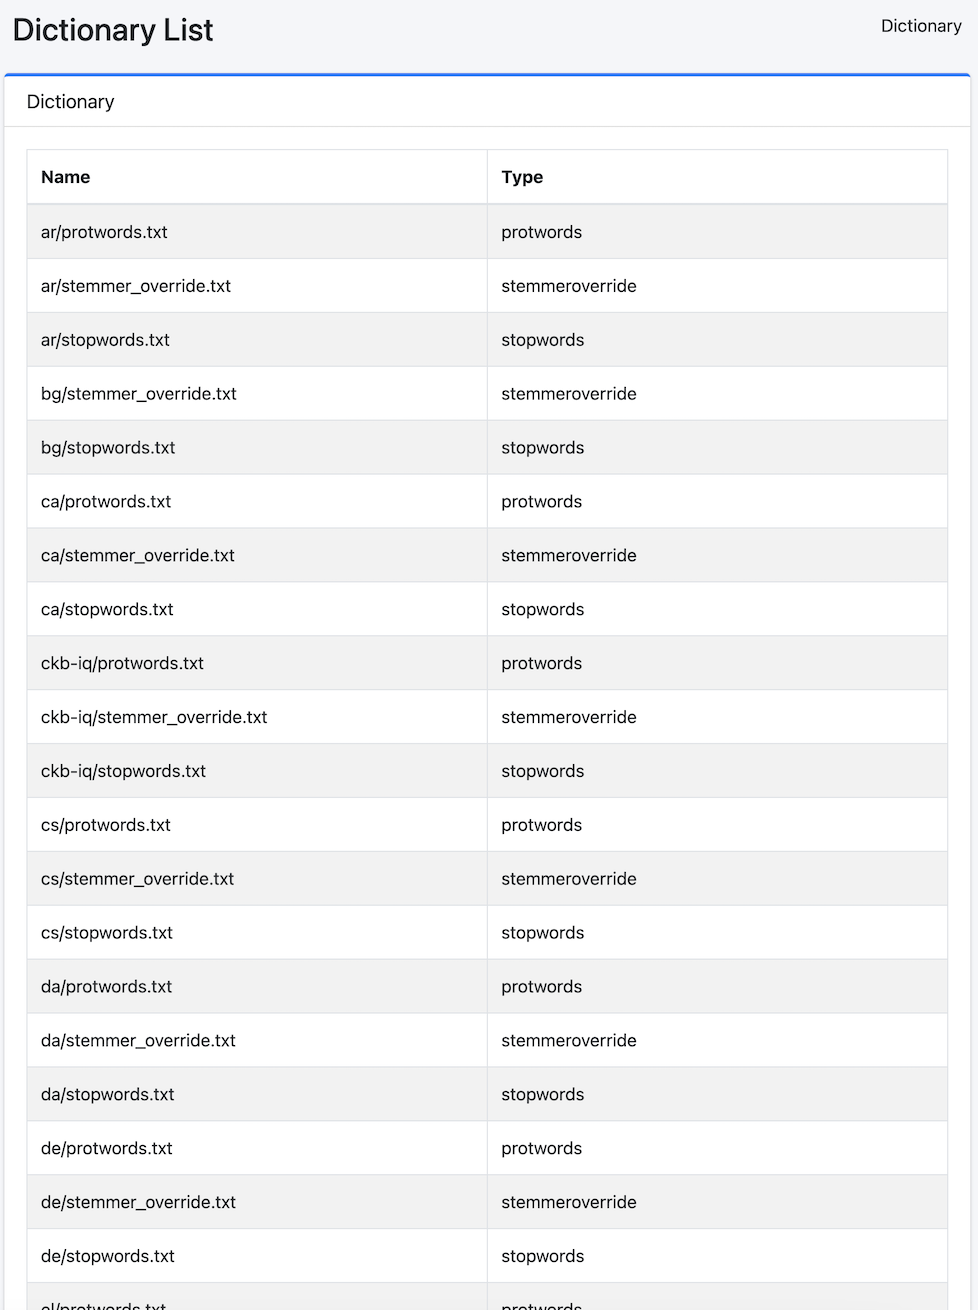
Portée de chaque dictionnaire et moment de prise en compte
Chaque dictionnaire s’applique à des champs différents et prend effet à un moment différent. Si vous avez modifié un dictionnaire et que les résultats de recherche ne changent pas, commencez par consulter ce tableau.
| Dictionnaire | Fichier | Champs concernés | Moment de prise en compte |
|---|---|---|---|
| Kuromoji | ja/kuromoji.txt | Uniquement les champs _ja, comme content_ja | À l’indexation (un nouveau crawl est nécessaire) |
| Synonymes | synonym.txt | content et title | À la recherche (aucun nouveau crawl nécessaire) |
| Mappage (commun à toutes les langues) | mapping.txt | content et title | À l’indexation (un nouveau crawl est nécessaire) |
| Mappage (par langue) | ja/mapping.txt | Uniquement les champs _ja, comme content_ja | À l’indexation (un nouveau crawl est nécessaire) |
| Protwords | en/protwords.txt | content et title | À l’indexation et à la recherche |
| Mots vides | en/stopwords.txt | content et title | À l’indexation et à la recherche |
| Remplacement du stemmer | en/stemmer_override.txt | content et title | À l’indexation et à la recherche |
Note
Un analyseur est construit à l’ouverture de l’index : la mise à jour d’un fichier de dictionnaire ne prend donc effet qu’après la fermeture puis la réouverture de l’index. De plus, un dictionnaire qui s’applique à l’indexation n’est pas appliqué rétroactivement aux documents déjà indexés ; ceux-ci doivent être crawlés de nouveau. Pour appliquer une modification, voir Appliquer les modifications d’un dictionnaire.
Avertissement
Le dictionnaire de substitution de caractères qui s’applique à content, le champ auquel répondent la plupart des recherches, est le mapping.txt de la racine, et non ja/mapping.txt. Ils portent le même nom Mappage mais ce sont deux fichiers distincts.
Appliquer les modifications d’un dictionnaire
Enregistrer un dictionnaire ne modifie pas les résultats de recherche, quel que soit le temps d’attente. Le plugin configsync d’OpenSearch écrit les dictionnaires enregistrés dans leurs fichiers environ une fois par minute, mais un analyseur ne lit ses dictionnaires qu’à l’ouverture de l’index : un index déjà ouvert continue donc d’utiliser les anciens. Après avoir modifié des dictionnaires, rechargez l’index de documents :
Ouvrez [Informations système > Maintenance] dans le menu de gauche.
Cliquez sur [Recharger] sous « Recharger l’index des documents ».
Le bouton écrit d’abord les dictionnaires enregistrés dans leurs fichiers, puis ferme et rouvre l’index vers lequel pointe l’alias fess.update ; il n’est donc pas nécessaire d’attendre l’écriture périodique. Un dictionnaire qui s’applique à la recherche, comme un synonyme, prend effet dès que l’index est de nouveau ouvert. Pour un dictionnaire qui s’applique à l’indexation, crawlez également de nouveau les documents concernés.
Avertissement
Tant que l’index est fermé, et jusqu’à ce que ses shards soient de nouveau affectés après son ouverture, l’index ne peut pas être interrogé : les recherches échouent ou ne renvoient aucun résultat. Plus l’index est volumineux, plus cela dure ; rechargez-le donc à un moment calme.
Pour faire la même chose depuis un script, sans l’écran d’administration, envoyez les mêmes opérations à OpenSearch :
_configsync/flush écrit immédiatement les dictionnaires enregistrés dans leurs fichiers. Sans cet appel, attendez au moins une minute après l’enregistrement avant de fermer l’index.
Le dictionnaire utilisateur Kuromoji et les résultats de recherche
Le champ content est analysé avec le tokenizer standard et cjk_bigram ; il ne dépend donc pas de la façon dont Kuromoji découpe un mot. Enregistrer un mot composé japonais dans le dictionnaire utilisateur Kuromoji puis relancer un crawl ne change donc rien à ce que renvoie une recherche sur content. L’enregistrement se manifeste dans content_ja, qui est ajouté à la requête selon la langue de la demande.
Kuromoji
Gère le dictionnaire pour l’analyse morphologique japonaise. ja/kuromoji.txt est le fichier de dictionnaire pour l’analyse morphologique japonaise.
Synonyme
Gère le dictionnaire de synonymes. synonym.txt est le fichier de dictionnaire de synonymes utilisé en commun pour toutes les langues.
Mapping
Gère le dictionnaire de remplacement de caractères. mapping.txt est le fichier de dictionnaire de remplacement de mots commun à toutes les langues ou pour chaque langue.
Protwords
Gère le dictionnaire de mots protégés. protwords.txt est placé pour chaque langue et est un fichier de liste de mots à exclure du stemming.
Mots vides
Gère le dictionnaire de mots vides. stopwords.txt est placé pour chaque langue et est un fichier de liste de mots à exclure lors de la création de l’index.
Remplacement de Stemmer
Gère le dictionnaire de remplacement de stemmer. stemmer_override.txt est placé pour chaque langue et est un fichier de dictionnaire de remplacement de mots pour remplacer le traitement de stemming.